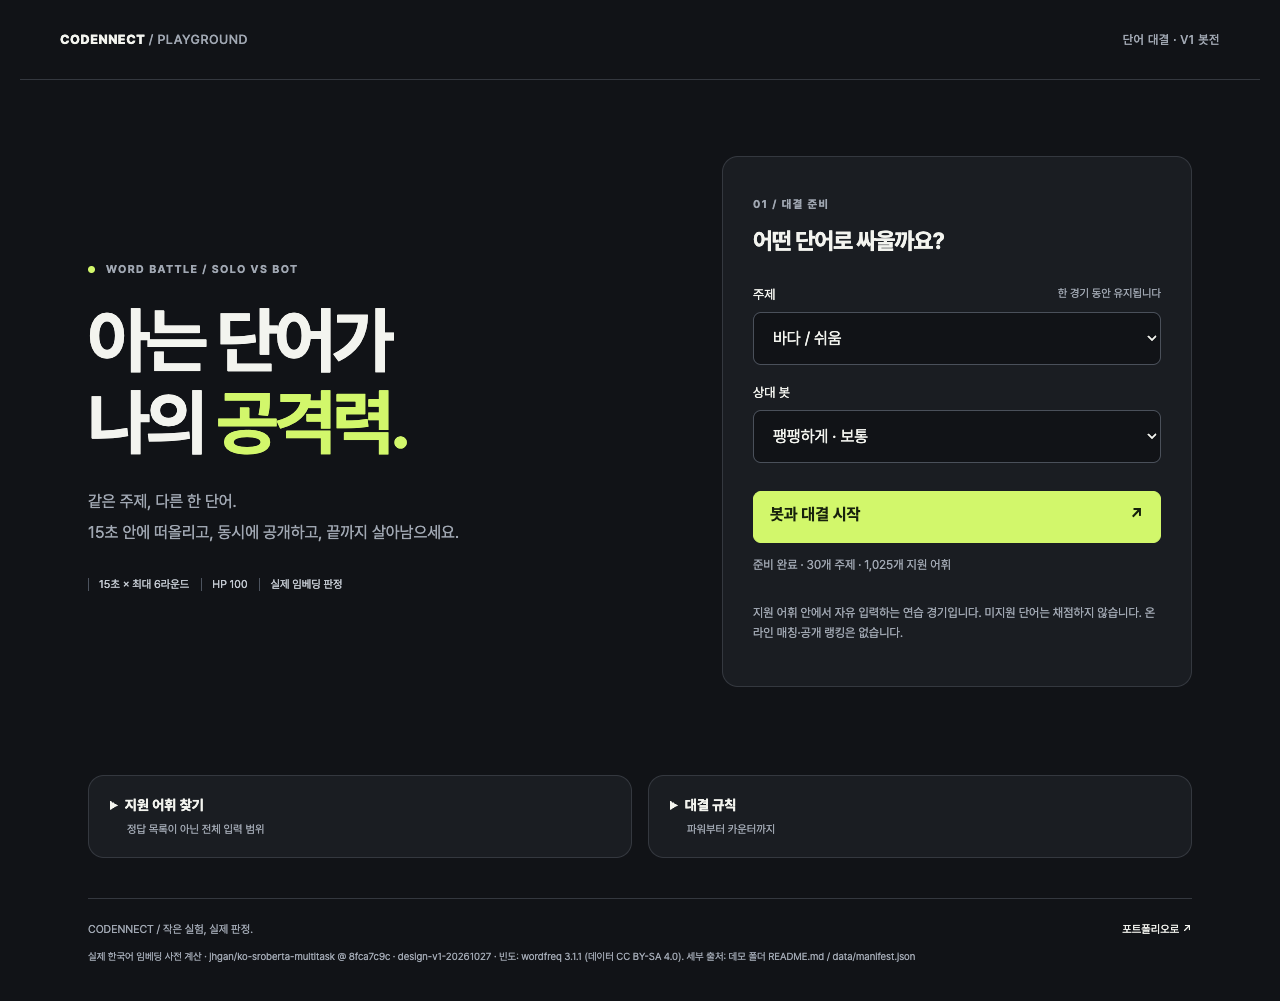
직접 체험할 수 있는 데모와 공개 저장소, 진행 중인 연구·제품 설계를 소개합니다.
단어대결 · Garden 게임 · 로컬 RAG


논문을 열고 질문하면 로컬 RAG가 답변과 인용 근거를 반환합니다. 실제 상주 백엔드와 연결한 읽기 데모 영상입니다.
업스트림 오픈소스 Bubblewrap와 Paperclip 계열 linux-bwrap를 실행 환경에 통합했습니다. 실제 Linux 샌드박스에서 워크스페이스 읽기 성공, 네트워크 차단, 시스템 경로 쓰기 거부를 버튼으로 확인할 수 있습니다.
자체 next-action 모델을 연구합니다. 고정 평가 게이트 2.80에 R1 점수는 2.01이며, 현재 DPO 판정·후속연구를 진행 중입니다.
허용한 PC 창의 화면을 로컬에 기록하고, 과거 활동을 한국어로 검색해 당시 화면 근거와 연결하는 소버린 LLM 제품을 설계하고 있습니다.
프롬프트 한 줄로 끝나지 않습니다. 데이터·모델·오케스트레이션·관제까지 직접 만들기 때문에 실제 제품으로 이어집니다.
도메인 데이터로 모델을 길들입니다. 작고 빠르고 정확하게.
여러 모델과 에이전트, 도구를 하나의 흐름으로 엮습니다.
데모를 실제로 돌아가는 서비스로 만들고 안정적으로 굴립니다.
Doyeon Baek(dosthcpp)이 소프트웨어 엔지니어링을 바탕으로 RAG, 에이전트 오케스트레이션과 AI 평가를 개발합니다.
GitHub 고정 프로젝트 tony-ai-lab-rag는 Ollama로 문서 검색과 답변 생성을 로컬에서 처리하는 RAG 베이스라인입니다.
대표 약력
등록 절차 — 한국 특허는 ① 출원(발명 명세서를 특허청에 제출, 출원번호 부여) → ② 심사청구(출원일로부터 3년 이내) → ③ 실체심사(심사관이 기존 기술 대비 신규성·진보성을 검토, 통상 1년 이상 소요) → ④ 거절이유 통지가 오면 의견서·보정서로 대응 → ⑤ 등록결정 → ⑥ 등록료 납부로 등록 완료 순서로 진행됩니다. 권리 존속기간은 출원일로부터 20년. "등록 진행 중"은 출원을 마치고 심사 단계에 있다는 의미입니다.
무엇을 출원했나 — 명세서 전문은 위 제품 카드의 SPEC 링크에서 그대로 열람할 수 있습니다.
사내 데이터로 모델을 만들수록 보안이 전부입니다. 격리 실행, 민감정보 비유출, 온프레미스 배포까지 — 보안을 기본값으로 설계합니다.
외부 앱·모델을 샌드박스(격리 VM)에서 돌려 시스템과 데이터에 손대지 못하게 막습니다.
어떤 정보가 어디로 나가려는지 실시간으로 잡아냅니다. 값이 아니라 필드 종류만 다뤄 안전합니다.
사내망·온디바이스에서 모델과 데이터를 직접 보유합니다. 클라우드 외부 의존 없이.
실제로 동작하는 걸 보세요 — Waydroid 유출 감지 라이브 →
API 한 번 호출로 끝나는 데모가 아니라, 도메인에 맞춘 모델과 운영까지 직접 만듭니다.
슬라이드가 아니라 손으로 만져지는 결과물로 빠르게 검증하고, 거기서부터 함께 키웁니다.
문제를 근본부터 질문합니다. 당연해 보이는 답을 의심하는 데서 시작.
데이터·모델·오케스트레이션 구조를 잡고 가장 빠른 검증 경로를 설계.
4주 안에 브라우저에서 돌아가는 첫 데모. 실제로 만져보고 방향을 확정.
파인튜닝·운영 자동화로 데모를 안정적인 서비스로 끌어올립니다.
속도·정확도·비용 — 실제 운영에서 의미 있는 축으로 끌어올립니다.
* 정확한 도입 효과 수치는 프로젝트별로 측정해 공유드립니다.
현장에서 실제로 부딪히고 해결한 주제들입니다.
작은 도메인 모델이 큰 범용 모델을 이기는 지점, 데이터 큐레이션의 기술.
원리 — 사전학습된 LLM의 원래 가중치(수십억 개의 숫자)는 그대로 얼려두고, 옆에 LoRA 어댑터라는 작은 행렬 한 쌍만 붙여 그 부분만 학습합니다. "이 입력엔 이런 출력" 예시 수천 개를 반복해서 보여주며, 모델이 낸 답과 정답의 차이(loss)를 줄이는 방향으로 어댑터의 숫자를 조금씩 조정하는 것(경사하강)이 학습의 전부입니다. QLoRA는 본체를 4비트로 압축해 이 과정을 GPU 한 장으로 돌리는 기법입니다.
작은 모델이 큰 모델을 이기는 이유: 범용 지식 대신 한 도메인의 패턴에만 용량을 집중시키기 때문입니다.
여러 모델·도구를 안정적으로 엮는 워크플로와 관제 패턴.
원리 — LLM 자체는 "텍스트를 넣으면 텍스트가 나오는 함수"일 뿐입니다. 에이전트는 이 함수를 루프에 넣은 것입니다: ① 현재 상태(이슈·목표·이전 기록)를 읽고 → ② 다음 행동을 스스로 결정하고 → ③ 도구(터미널·API·브라우저)를 실제로 호출하고 → ④ 그 결과를 다시 읽으며 반복. 이 관찰→행동 루프가 에이전트의 심장입니다.
루프를 현장에서 안정적으로 돌리는 장치:
격리 실행과 네트워크 유출 탐지로 사내 데이터를 지키는 법.
원리 — 추론(모델 실행)을 클라우드 API가 아니라 사내·홈랩 GPU에서 수행하면, 프롬프트와 문서가 애초에 회사 밖으로 나가지 않습니다. 그 위에 3중 안전장치를 겹칩니다:
클라우드 API 대비: 데이터 잔류 리스크가 사라지고, 토큰 종량제 대신 비용이 고정됩니다.
범용 AI가 아니라 귀사 데이터·업무에 맞춘 맞춤 AI를 직접 개발합니다. RAG·파인튜닝으로 우리 회사만의 답을 내는 시스템을 만듭니다.
네. 공개 모델과 프롬프트·에이전트 설계만으로 시작하는 케이스도 많고, 데이터가 쌓이면 RAG·파인튜닝으로 정확도를 올립니다.
프로젝트 규모에 따라 다릅니다. 작은 챗봇·업무자동화부터 대규모 시스템까지, 범위를 함께 정해 견적을 드립니다.
아니요. 온프레미스·사내망 배포와 로컬 추론을 지원하며, 샌드박스 격리와 PII 유출 탐지로 데이터 반출을 차단합니다.
보통 4주 안에 브라우저에서 직접 만져보는 첫 데모를 드리고, 거기서부터 운영 제품으로 함께 키웁니다.
범용 API 토큰 과금 대신 경량 파인튜닝 모델·로컬 추론으로, 사용량이 늘어도 비용이 안정적입니다. 범위에 따라 견적을 드립니다.
네. 기존 데이터·업무 흐름에 맞춰 오케스트레이션을 설계하고 API·온프레미스로 통합합니다.